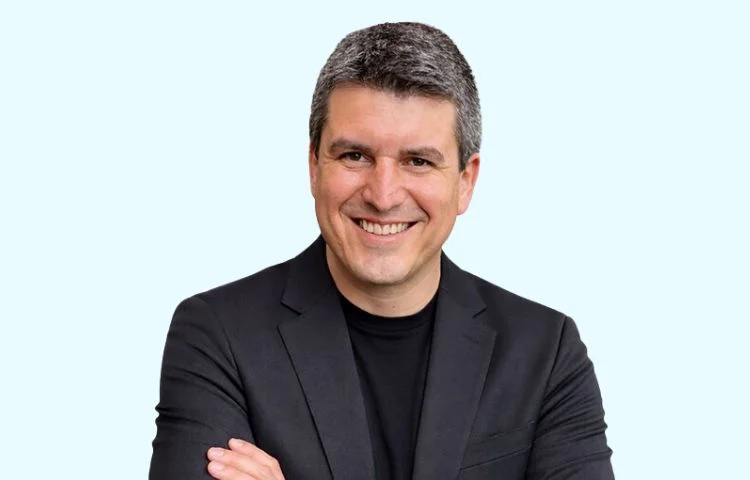
Scott Zoldi, Director de Analítica de FICO. Foto: Cortesía FICO. Portal ERP Colombia
El año pasado, las “alucinaciones” generadas por la inteligencia artificial generativa (GenAI) volvieron a ser el centro de atención en los tribunales y, por supuesto, en los titulares de todo el mundo. Más recientemente, Bloomberg News señaló que, en sus informes anuales de 2024, “Goldman Sachs Group Inc., Citigroup Inc., JPMorgan Chase & Co. y otras compañías de Wall Street están advirtiendo a los inversionistas sobre los nuevos riesgos derivados del creciente uso de la inteligencia artificial, incluidas las alucinaciones del software, los problemas de estado de ánimo entre los empleados, el uso por parte de ciberdelincuentes y el impacto de los cambios legislativos a nivel mundial.”
Mientras tanto, Michael Barr, quien recientemente dejó su cargo como vicepresidente de supervisión de la Reserva Federal de Estados Unidos, anticipó estas preocupaciones durante un encuentro en el Consejo de Relaciones Exteriores, en febrero pasado. Barr advirtió que la presión competitiva por incorporar inteligencia artificial generativa podría aumentar los riesgos en los servicios financieros. “Esa presión puede llevar a todas las instituciones, incluidas las reguladas, a adoptar un enfoque más agresivo hacia la adopción de GenAI, lo que incrementaría los riesgos de gobernanza, alineación y financieros en torno a la IA”, señaló.
Coincido plenamente. Por eso, en FICO siempre hemos promovido el uso responsable de la GenAI, a través de soluciones como los modelos de lenguaje enfocados (FLM, por sus siglas en inglés), diseñados para prevenir las alucinaciones antes de que ocurran. En este artículo brindaré contexto sobre el fenómeno de las alucinaciones en la GenAI y explicaré cómo los FLM representan la propuesta de FICO para garantizar que la “edad dorada de la IA” se mantenga brillante y confiable.
Te puede interesar: Gemelos digitales: la revolución de la simulación en el sistema financiero
Las alucinaciones no son una ilusión
Las alucinaciones en la GenAI son un problema real. Por ejemplo, investigadores de la Universidad de Stanford descubrieron el año pasado que las herramientas de propósito general, como ChatGPT, tienen una tasa de error de hasta el 82% cuando se utilizan con fines legales. Las herramientas de GenAI diseñadas específicamente para aplicaciones jurídicas ofrecen mejores resultados —con una tasa de alucinaciones del 17%, según otro estudio de Stanford—, pero aun así requieren una revisión exhaustiva antes de su uso.
Sin importar el porcentaje de error, el riesgo aumenta cuando los resultados de la GenAI son utilizados directamente por humanos, quienes pueden no detectar la alucinación ni verificar la información antes de actuar en función de ella.
El combustible que alimenta el problema
Entre los factores que pueden generar alucinaciones en los modelos de GenAI se incluyen:
-
La calidad, cantidad y diversidad de los datos usados en el preentrenamiento.
-
La baja cobertura de datos para ciertos tokens o temas clave, lo que puede llevar al modelo a inferencias basadas en “ruido” en lugar de señales respaldadas por información sólida.
-
La falta de autocontrol en los modelos de lenguaje (LLM), que no verifican si existe suficiente cobertura para sustentar una respuesta y, en cambio, asumen su validez estadística. Idealmente, el modelo debería reconocer cuando carece de información suficiente y abstenerse de responder.
-
El uso incorrecto de técnicas como la generación aumentada de recuperación (RAG), que puede incrementar la tasa de alucinaciones al alterar las relaciones aprendidas durante el entrenamiento original.
Las alucinaciones son difíciles de detectar
Detectar alucinaciones resulta complejo, ya que los algoritmos de los LLM suelen carecer de interpretabilidad y transparencia. Incluso cuando una respuesta hace referencia a un contexto RAG, una revisión humana podría revelar que ese contexto no fue realmente utilizado.
La forma más eficaz de reducir las alucinaciones es que las organizaciones desarrollen sus propios modelos de IA generativa preentrenados, enfocados en dominios y tareas específicas. Este enfoque permite controlar los datos utilizados durante el entrenamiento —donde suelen originarse las alucinaciones— y limitar el uso de la contextualización aumentada, garantizando que refuerce el conocimiento previo en lugar de distorsionarlo.
Además, las políticas empresariales deben definir claramente cómo se emplearán los resultados de estas herramientas en los procesos de negocio, estableciendo mecanismos de verificación antes de su implementación.
Los FLM: precisión y confianza
La estrategia de FICO para el uso responsable de la IA generativa se basa en los modelos de lenguaje pequeños (SLM, por sus siglas en inglés), diseñados para realizar tareas lingüísticas específicas de forma eficiente. Estos modelos, con menos parámetros y datos de entrenamiento, presentan menor riesgo que los LLM tradicionales.
Los modelos de lenguaje enfocados (FLM) representan una evolución de los SLM: se desarrollan sobre conjuntos de datos más pequeños pero cuidadosamente seleccionados, centrados en una tarea o dominio muy específico. Este alto nivel de especialización garantiza datos de alta calidad y permite un ajuste preciso del modelo (task tuning) para optimizar su desempeño.
A diferencia de los modelos comerciales disponibles, los FLM brindan transparencia y control sobre los datos utilizados en su entrenamiento —una capacidad esencial para evitar alucinaciones— y pueden generar puntuaciones de confianza para cada respuesta. Estas puntuaciones permiten evaluar el nivel de alineación de las respuestas con el conocimiento validado del dominio, facilitando una gestión basada en riesgos para la IA generativa.